
Reddit热议!老外怎么看8GB显卡跑262K上下文大模型?
2026-10-25 06:39:15
32次阅读
3个评论
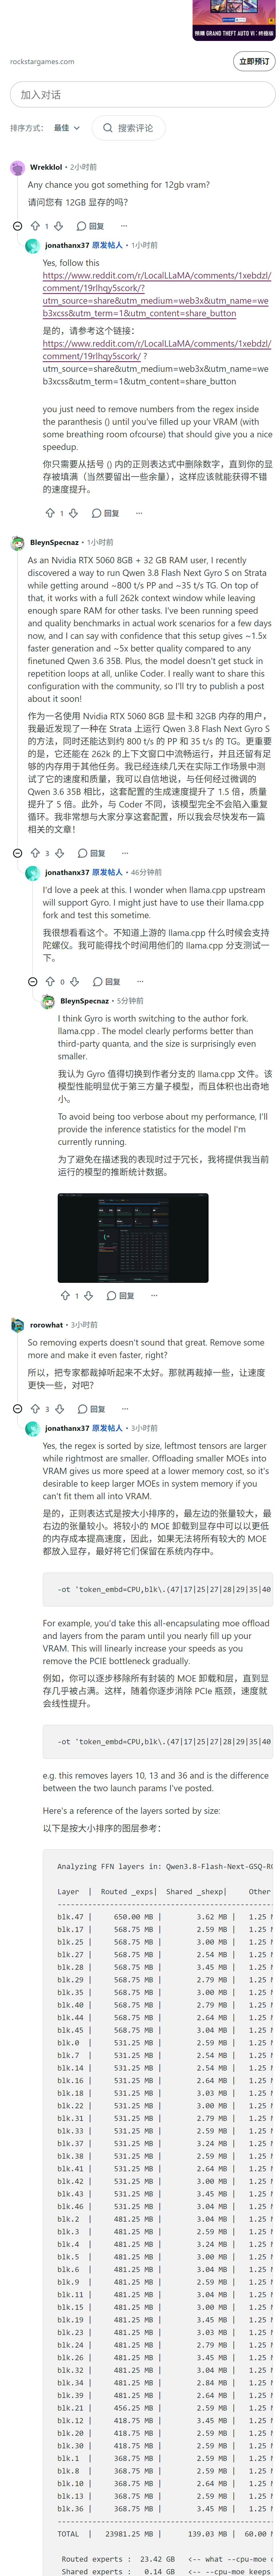
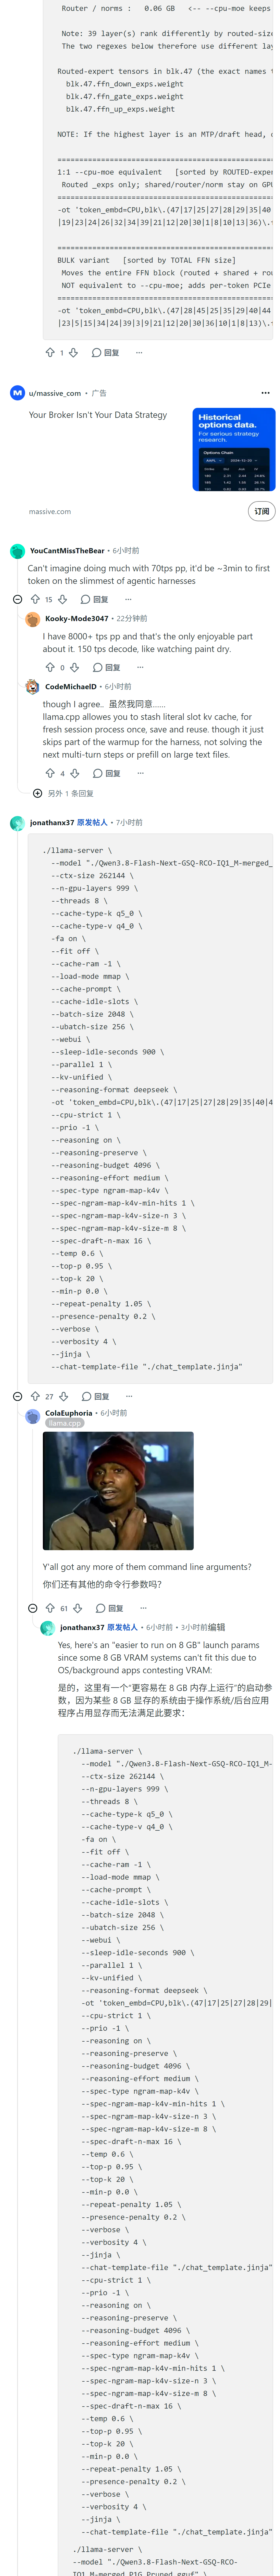
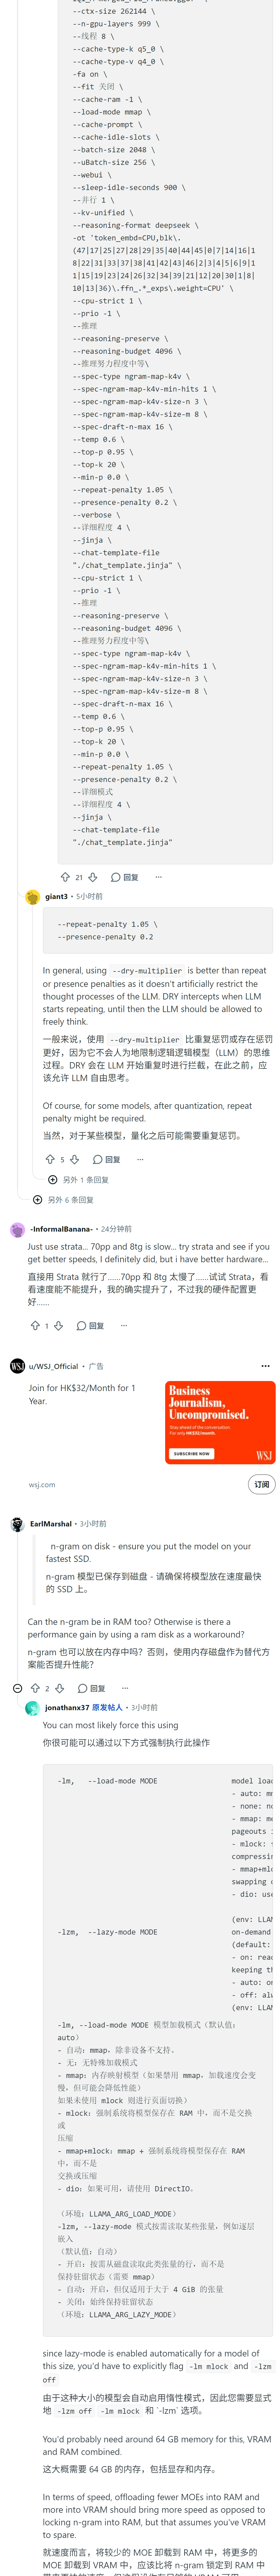
网友分享用llama.cpp在8GB显存+24GB内存上运行Qwen-Flash-Next Coder,通过将MOE卸载到内存、n-gram放SSD实现70T/s预处理和8T/s生成,但CUDA下8GB易失败需改用Vulkan,评论区还讨论了12GB配置、正则调优及与Strata方案的性能对比。
0
0
 小陈
manage
advert
2026-10-25 06:39:48
回复 |
引用
小陈
manage
advert
2026-10-25 06:40:17
回复 |
引用
小陈
manage
advert
2026-10-25 06:40:46
回复 |
引用
共3条
1

相关帖子
- Reddit热帖!16GB显卡硬刚27B大模型,100K上下文跑满速
- Reddit热议!8GB内存跑2.78T参数大模型,老外怎么看?
- 本地运行Qwen 3.6 MTP模型:300K上下文实测与性能飞跃
- 12GB显存跑Qwen3.6 35B:80tok/s+128K上下文!llama.cpp MTP攻略
- Reddit热议!老外如何评价DeepSeek V4 Flash本地跑满1M上下文?
- Reddit热议!M5 Max跑通1M上下文,生成速度还这么猛?
- Reddit热议!MiniMax M3模型发布,百万上下文+多模态引期待
- 16GB显存跑大LLM妙招:插旧6GB+显存显卡扩容提速
- Claude上下文token占用离谱引AI使用认知热议
- Reddit热议!大神用C语言在8GB内存CPU上跑起2.8万亿参数Kimi K3