
Reddit热议!老外怎么看本地量化模型真实修bug能力?
2026-11-03 08:14:08
8次阅读
3个评论
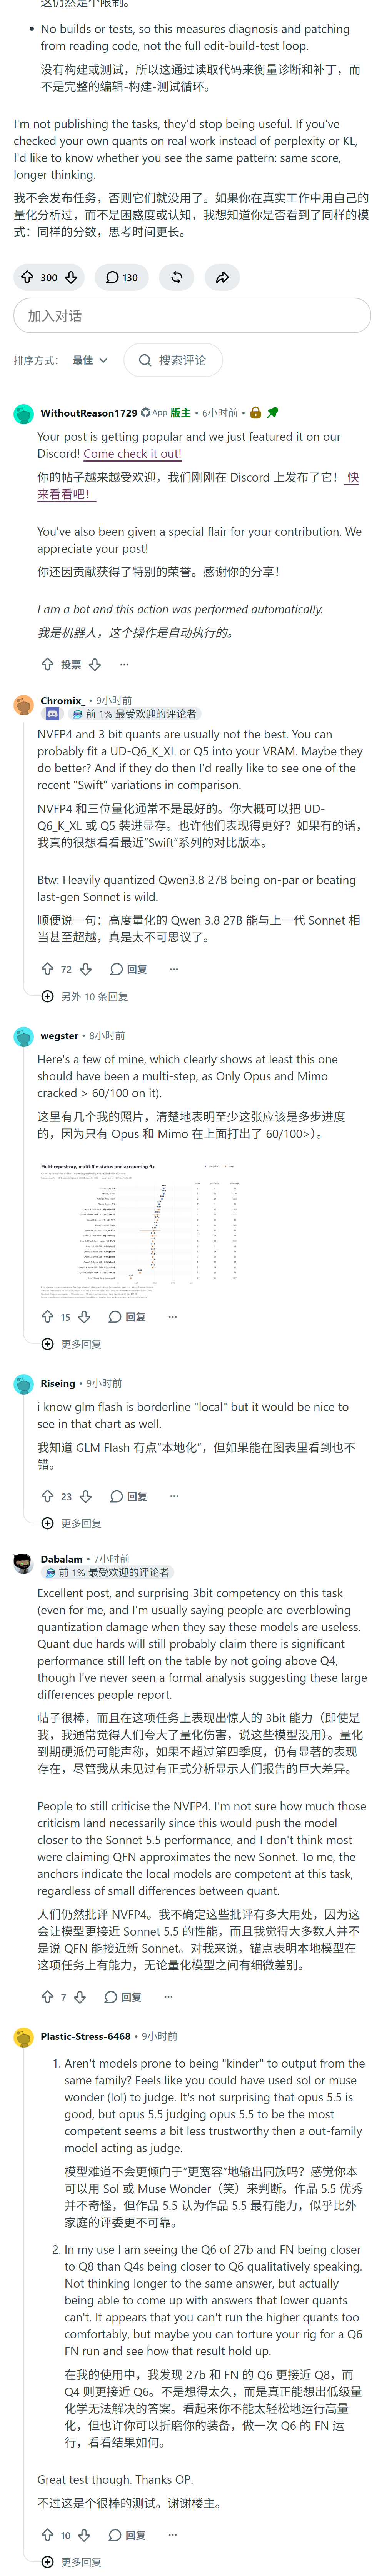
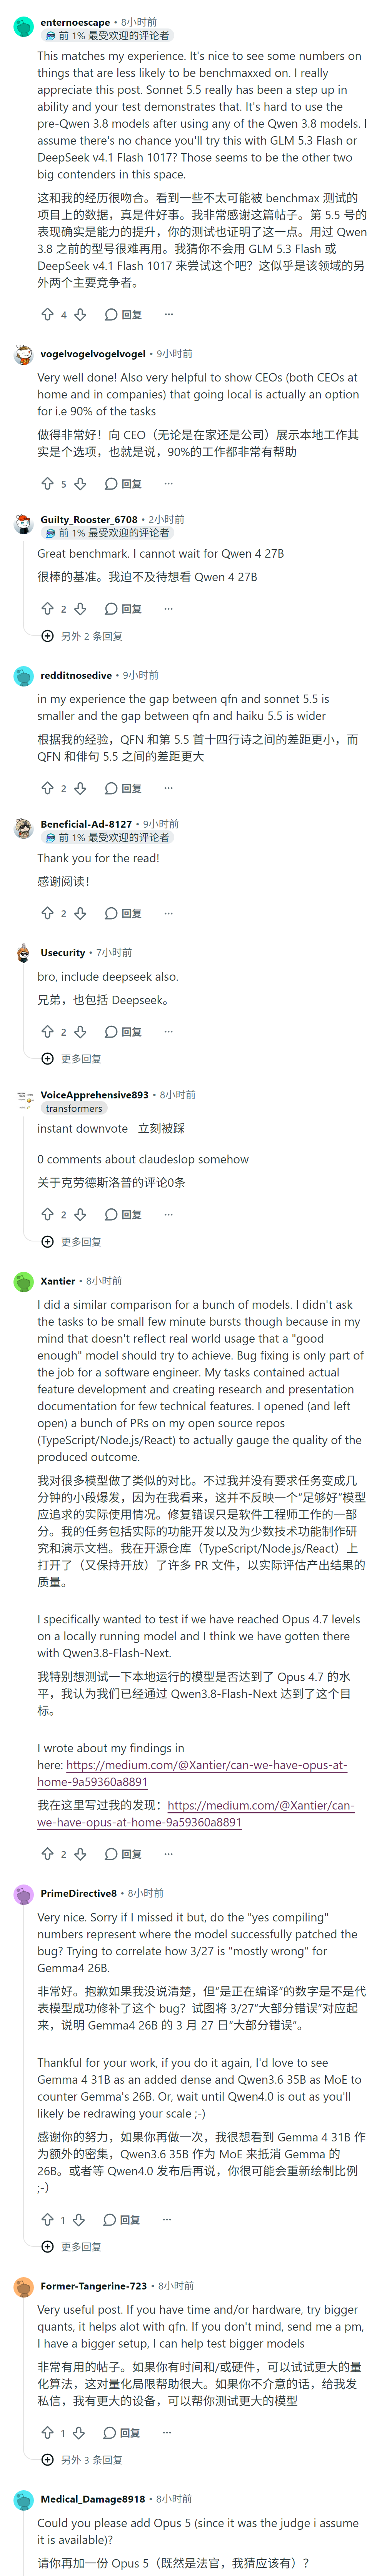
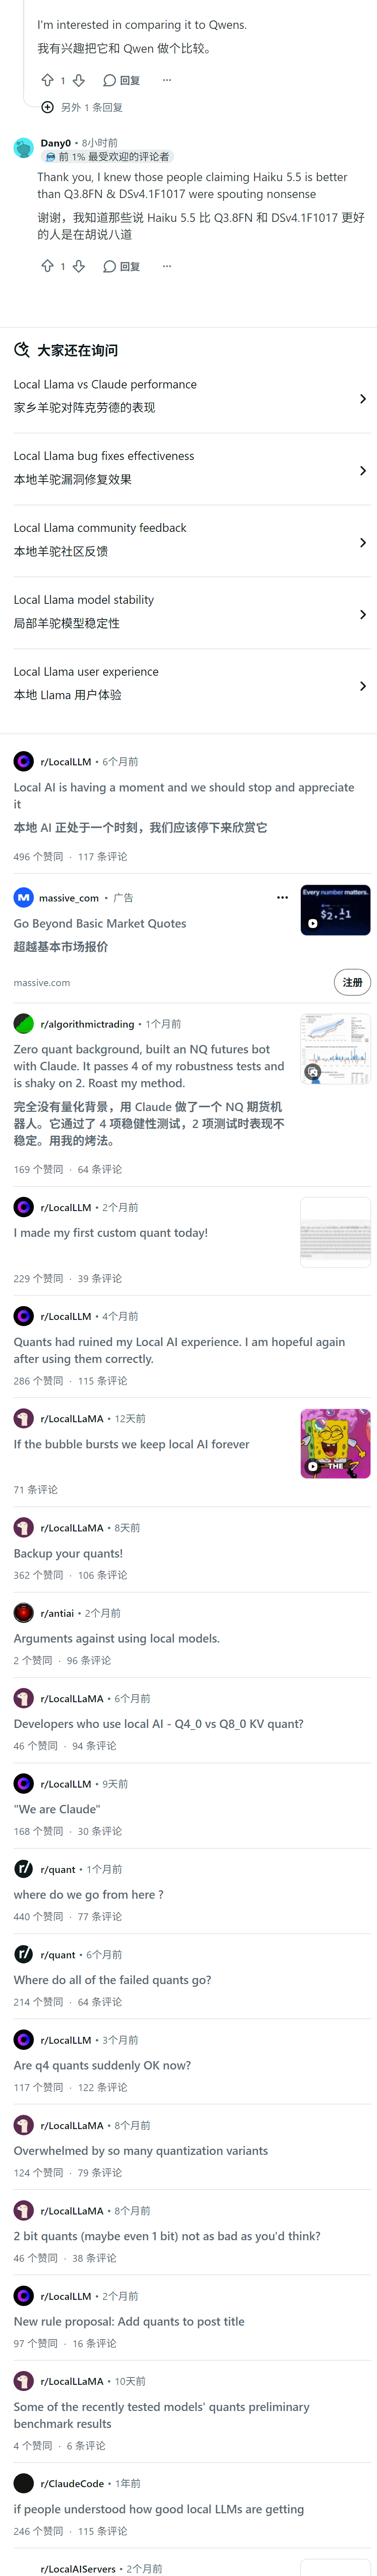
网友用9个真实C++/CUDA bug测试本地量化模型与Claude,发现3-bit量化并未降低得分,而是让模型思考更久才达到同样效果;Qwen3.8-Flash-Next表现接近Claude Haiku 5.5,评论区围绕量化精度、评判偏见和测试局限展开讨论。

0
0
 小陈
manage
advert
2026-11-03 08:14:41
回复 |
引用
小陈
manage
advert
2026-11-03 08:15:10
回复 |
引用
小陈
manage
advert
2026-11-03 08:15:39
回复 |
引用
共3条
1

相关帖子
- Reddit热议!老外怎么看Unsloth发布DeepSeek量化新模型?
- Reddit热议!老外怎么看Saluki 27B量化模型争议?
- Reddit热议!老外怎么看1-bit量化763B模型?
- Reddit热议!老外怎么看AI监管与本地模型之争?
- Reddit热议!老外怎么看Opus编排本地模型写代码?
- Reddit热议!老外怎么看Codex CLI让本地模型逆袭?
- Reddit热议!老外怎么看待DeepSeek模型本地运行?
- Reddit热议!老外怎么看Engram技术让本地小模型逆袭?
- Reddit热议!老外怎么看10-16GB显存本地模型排行榜?
- Reddit热议!老外怎么看英伟达2比特74B本地大模型?