
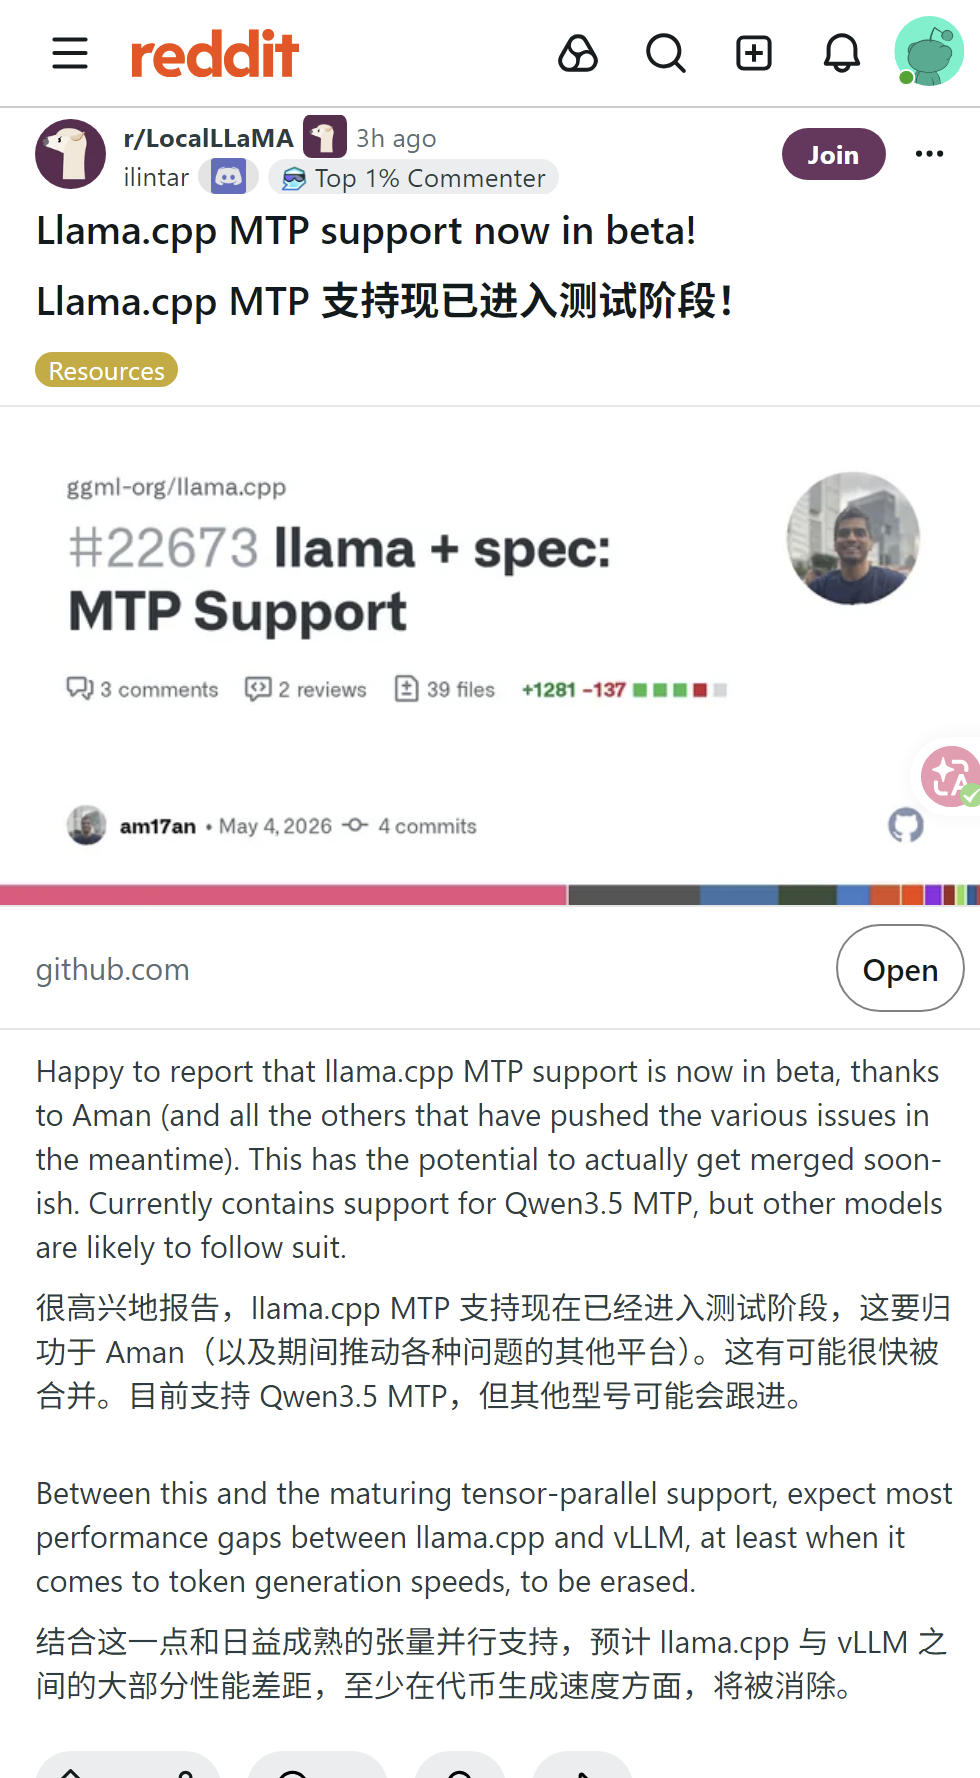
llama.cpp MTP支持进入beta 本地大模型推理大幅提速
2026-05-05 01:47:36
396次阅读
3个评论
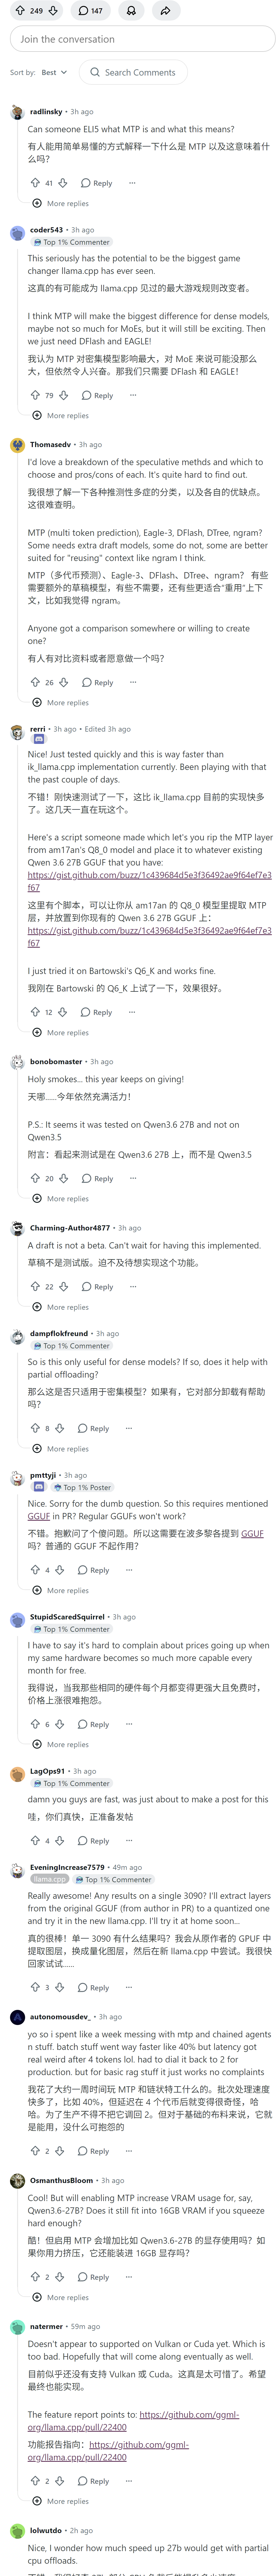
本次新增的MTP为内置多令牌预测的自推测解码技术,无需额外草稿模型,有望近期正式合并,目前适配Qwen3.5/3.6系列,稠密模型提速1.5-2倍,MoE提速30-40%,配合张量并行有望追平vLLM,开启后显存增2.7-3.1G,不建议量化MTP层。
0
0
 小陈
manage
advert
2026-05-05 01:48:09
回复 |
引用
小陈
manage
advert
2026-05-05 01:48:38
回复 |
引用
小陈
manage
advert
2026-05-05 01:49:06
回复 |
引用
共3条
1

相关帖子
- LLaMA.cpp实现MTP功能,Gemma4令牌生成提速40%
- Reddit热议!llama.cpp距离CPU推理提速仅差50个PR
- Reddit热议!llama.cpp正式支持DFlash,AI推理速度再提升
- Reddit热议!llama.cpp火速支持DeepSeek V4 Flash加速推理
- Reddit热议!llama.cpp新PR让Q2_0在x86 CPU上提速3倍
- Reddit热议!Nvidia收购HuggingFace,llama.cpp开源未来堪忧?
- 12GB显存跑Qwen3.6 35B:80tok/s+128K上下文!llama.cpp MTP攻略
- Reddit热议!llama.cpp新PR提升提示处理速度,网友疯狂更新
- Reddit热议!老外怎么看llama.cpp贡献者被封禁?
- 24GB显存跑Qwen 27B终极指南:ik_llama.cpp+MTP量化封神