
Reddit热议!老外怎么看llama.cpp为MoE专家加GPU缓存?
2026-10-08 07:52:07
91次阅读
3个评论
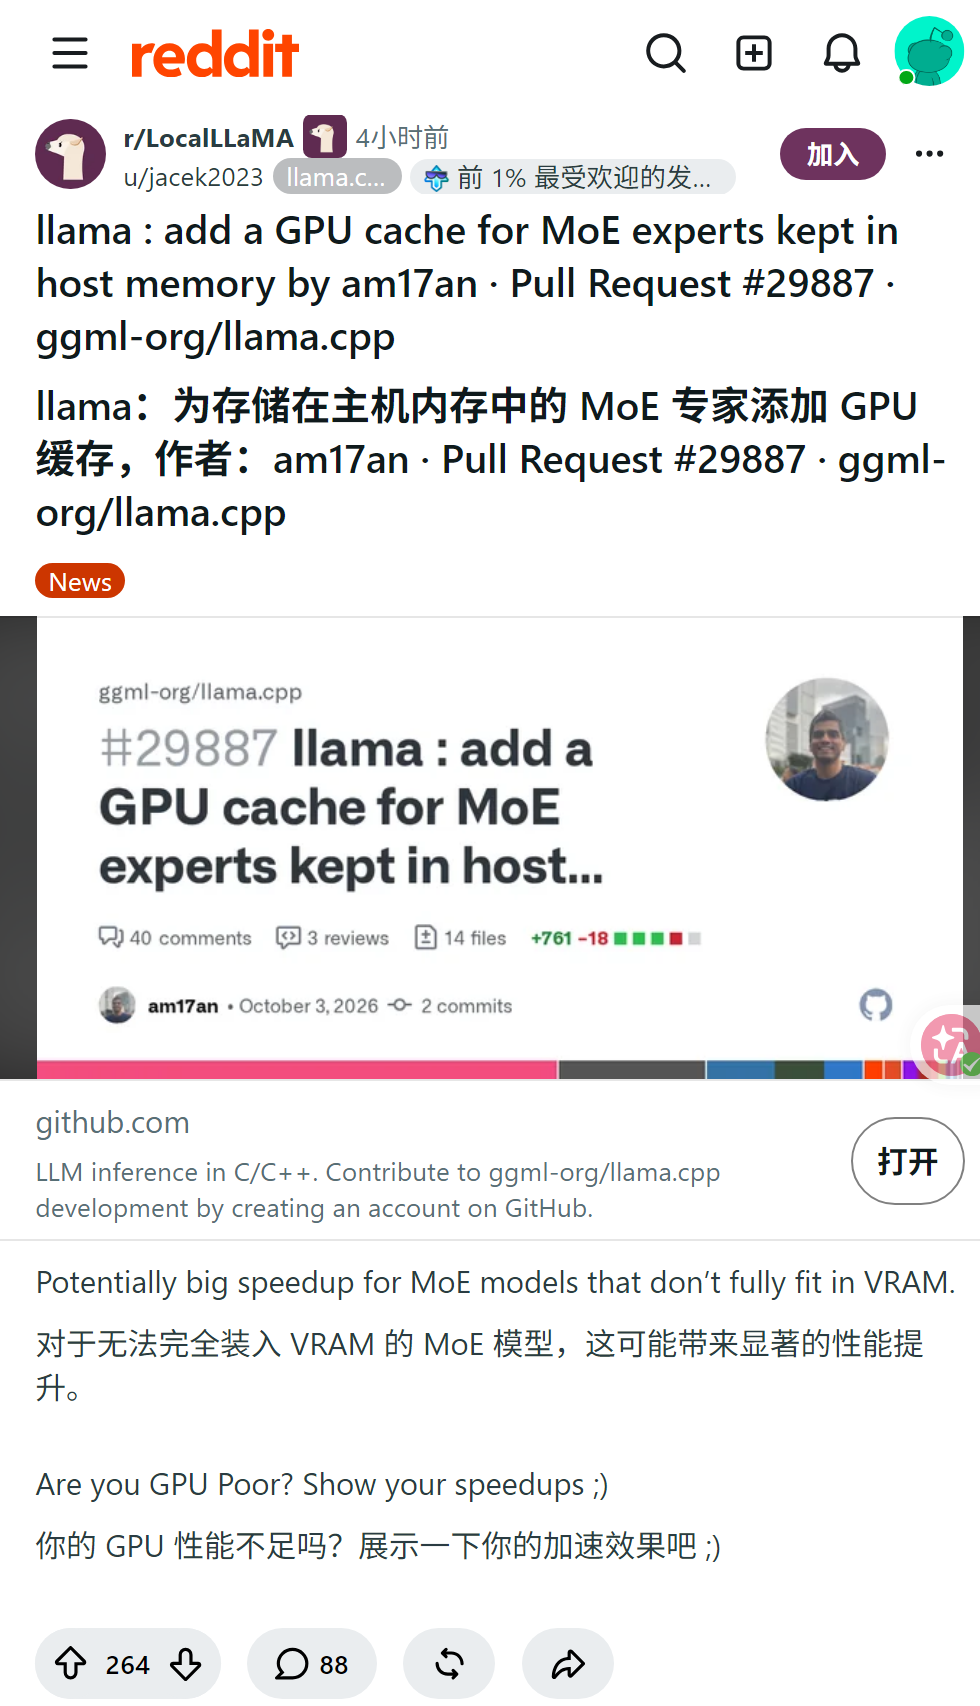
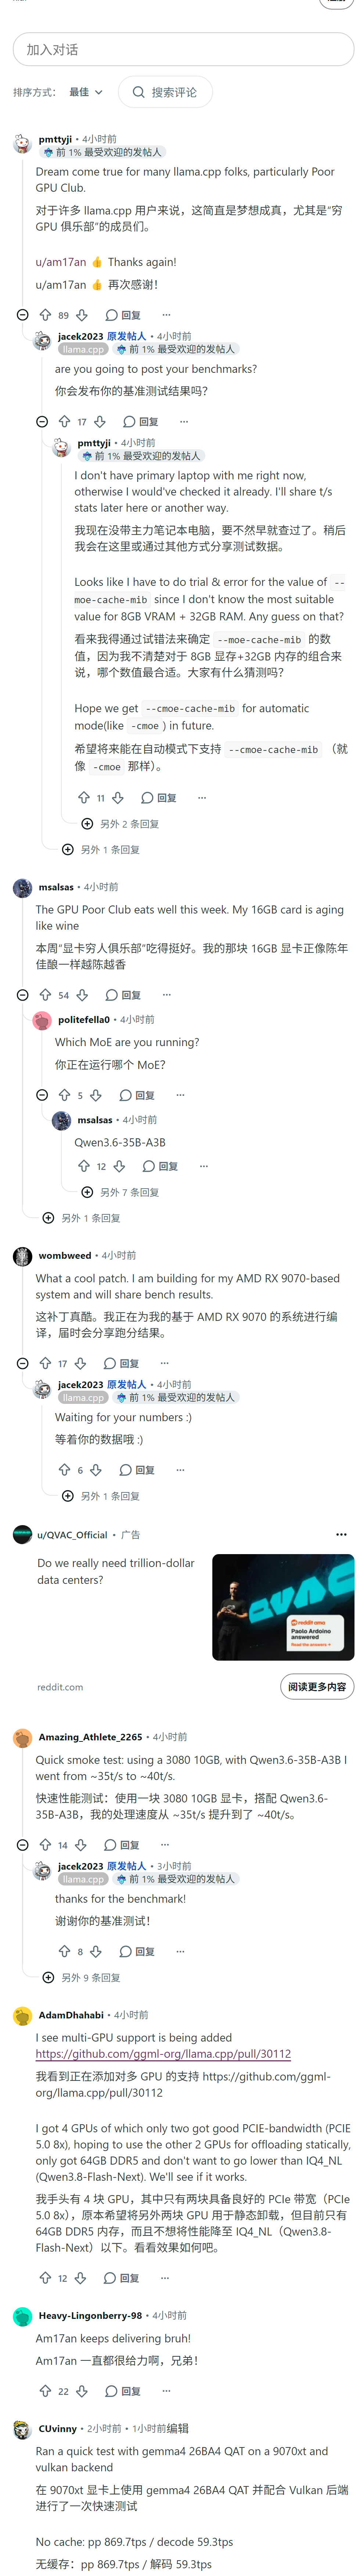
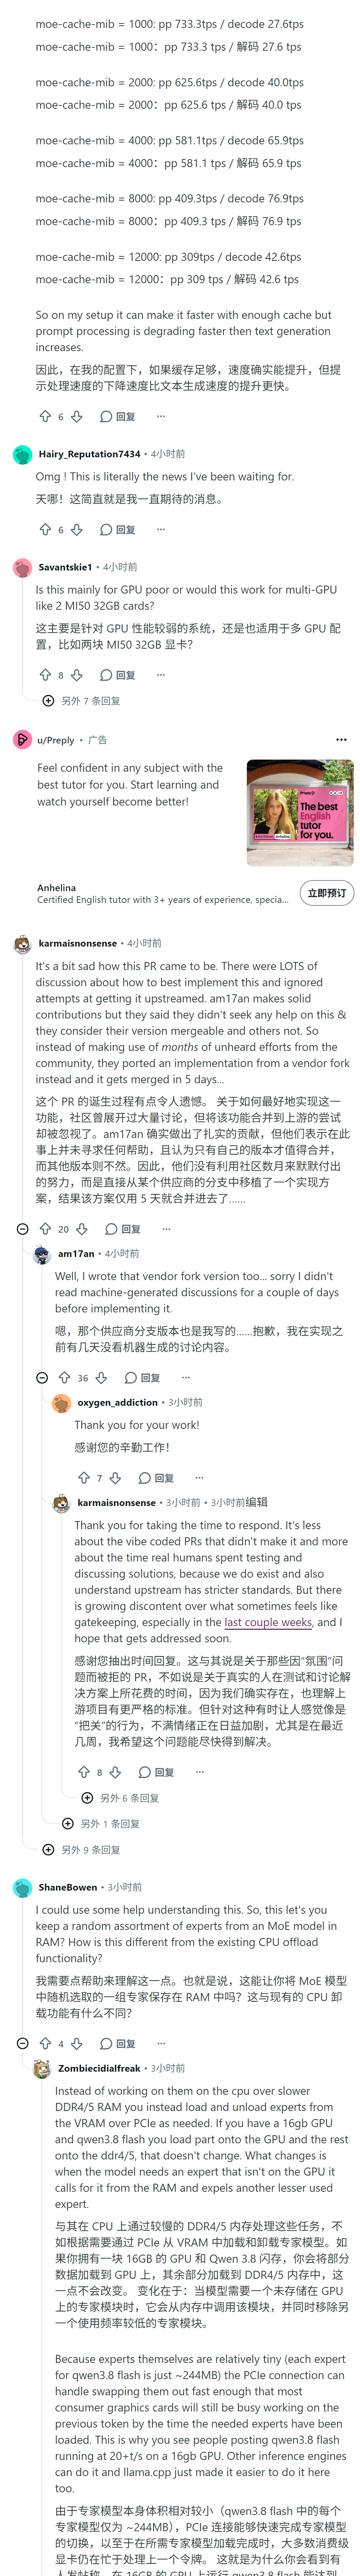
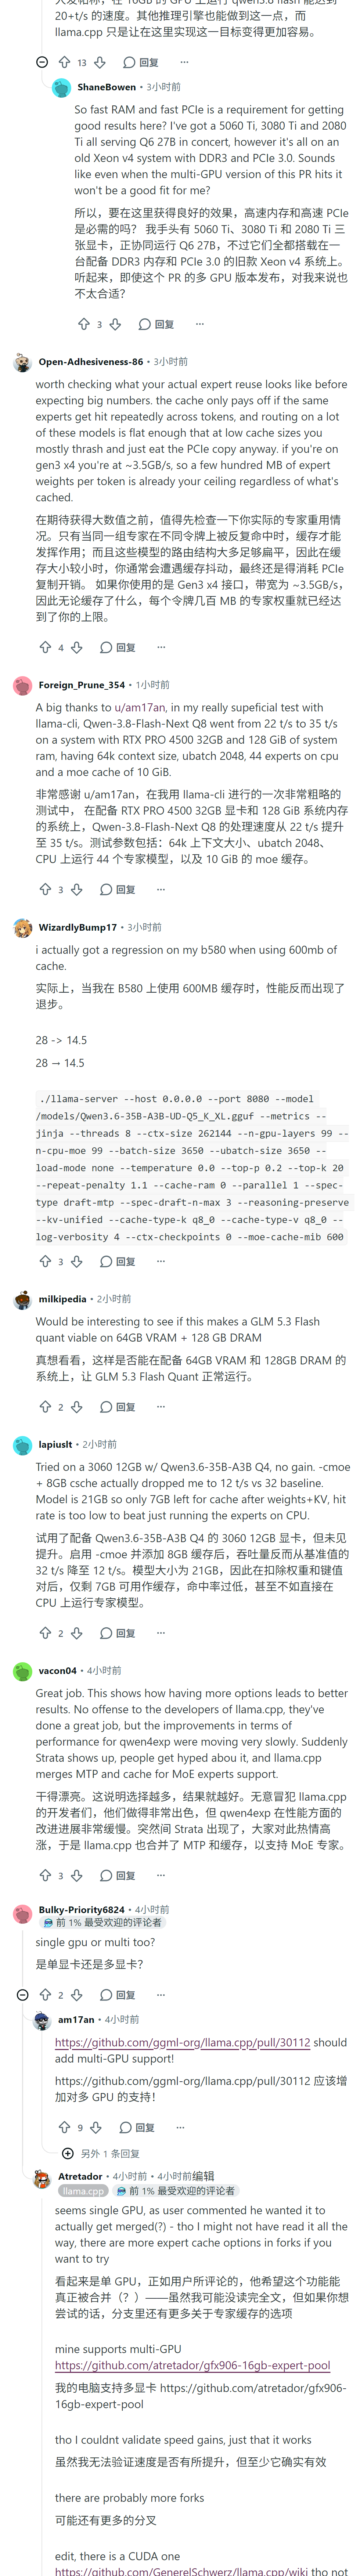
llama.cpp合并PR为显存不足的MoE模型带来GPU专家缓存,网友直呼“穷显卡俱乐部”的福音。实测有人提速5t/s,有人却因缓存命中率低反而降速,多GPU支持仍在路上。
0
0
 小陈
manage
advert
2026-10-08 07:52:40
回复 |
引用
小陈
manage
advert
2026-10-08 07:53:09
回复 |
引用
小陈
manage
advert
2026-10-08 07:53:38
回复 |
引用
共3条
1

相关帖子
- Reddit热议!老外怎么看llama.cpp登上微软舞台?
- Reddit热议!老外怎么看llama.cpp贡献者被封禁?
- Reddit热议!老外怎么看llama.cpp v0.6.0发布?
- Reddit热议!Nvidia收购HuggingFace,llama.cpp开源未来堪忧?
- Reddit热议!llama.cpp正式支持DFlash,AI推理速度再提升
- llama.cpp MTP支持进入beta 本地大模型推理大幅提速
- LLaMA.cpp实现MTP功能,Gemma4令牌生成提速40%
- Reddit热议!llama.cpp新PR提升提示处理速度,网友疯狂更新
- Reddit热议!llama.cpp火速支持DeepSeek V4 Flash加速推理
- Reddit热议!llama.cpp距离CPU推理提速仅差50个PR